Sliding Window Attention Training for Efficient Large Language Models
IEEE International Conference on Data Mining (ICDM), 2026, 2026
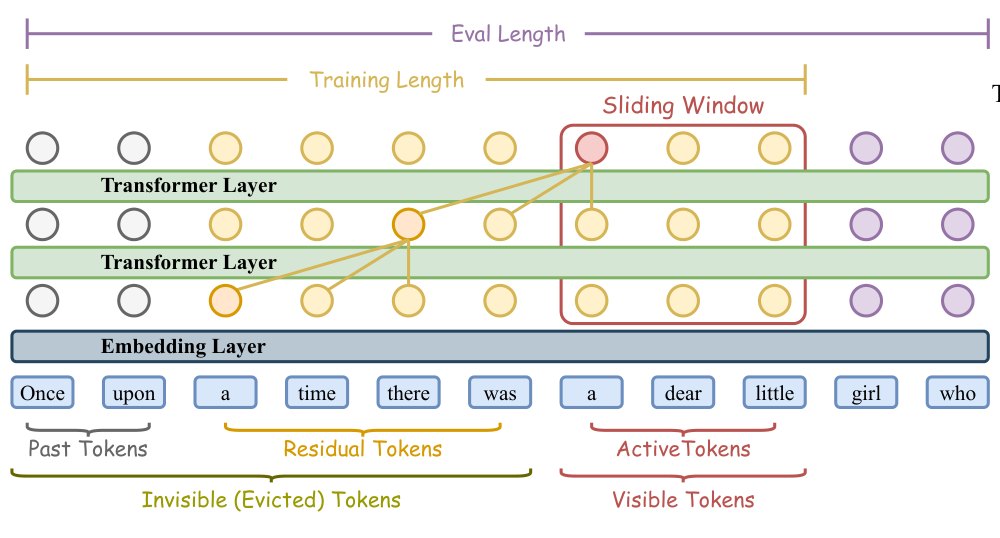
SWAT enables efficient long-context handling via Sliding Window Attention Training, replacing softmax with sigmoid and combining balanced ALiBi with Rotary Position Embedding to retain information.
Paper: arXiv:2502.18845 Code: fzkuji2026/ICDM2026_SWAT-Attention